 Auditoría SEO
¿Llega la búsqueda con IA
al sitio de tu cliente?
Un rastreo del sitio web propio del cliente que empieza por la búsqueda con IA: qué rastreadores de IA dejan pasar el robots.txt y el cortafuegos, qué páginas citadas están rotas, qué lee un rastreador en el HTML. Después, las comprobaciones SEO clásicas, con cada problema ordenado por lo que valen las páginas que toca.
Las páginas están incluidas en el plan: no se cobra nada por página y no hay recargo por exceso. Lee el HTML que envía tu servidor y no ejecuta JavaScript.
Primero la búsqueda con IA, luego lo demás
La mayoría de las herramientas de auditoría empiezan por los títulos y los enlaces rotos. Esta empieza por si la búsqueda con IA puede acceder al sitio y leerlo.
Acceso de los rastreadores de IA, comprobado
El robots.txt se contrasta página a página con los rastreadores de búsqueda con IA y los recuperadores de IA. Después, la auditoría pide la página de inicio una vez con el user agent publicado de cada uno de los 8 rastreadores de IA, lo que delata un cortafuegos o una CDN que rechaza a un rastreador que el robots.txt permite. Un rechazo se informa como rechazo, con la capa cuando se puede nombrar. Si conectas tus logs de servidor, también muestra dónde se rechazó a rastreadores de IA verificados en los últimos 14 días.
Páginas que citan las respuestas de IA
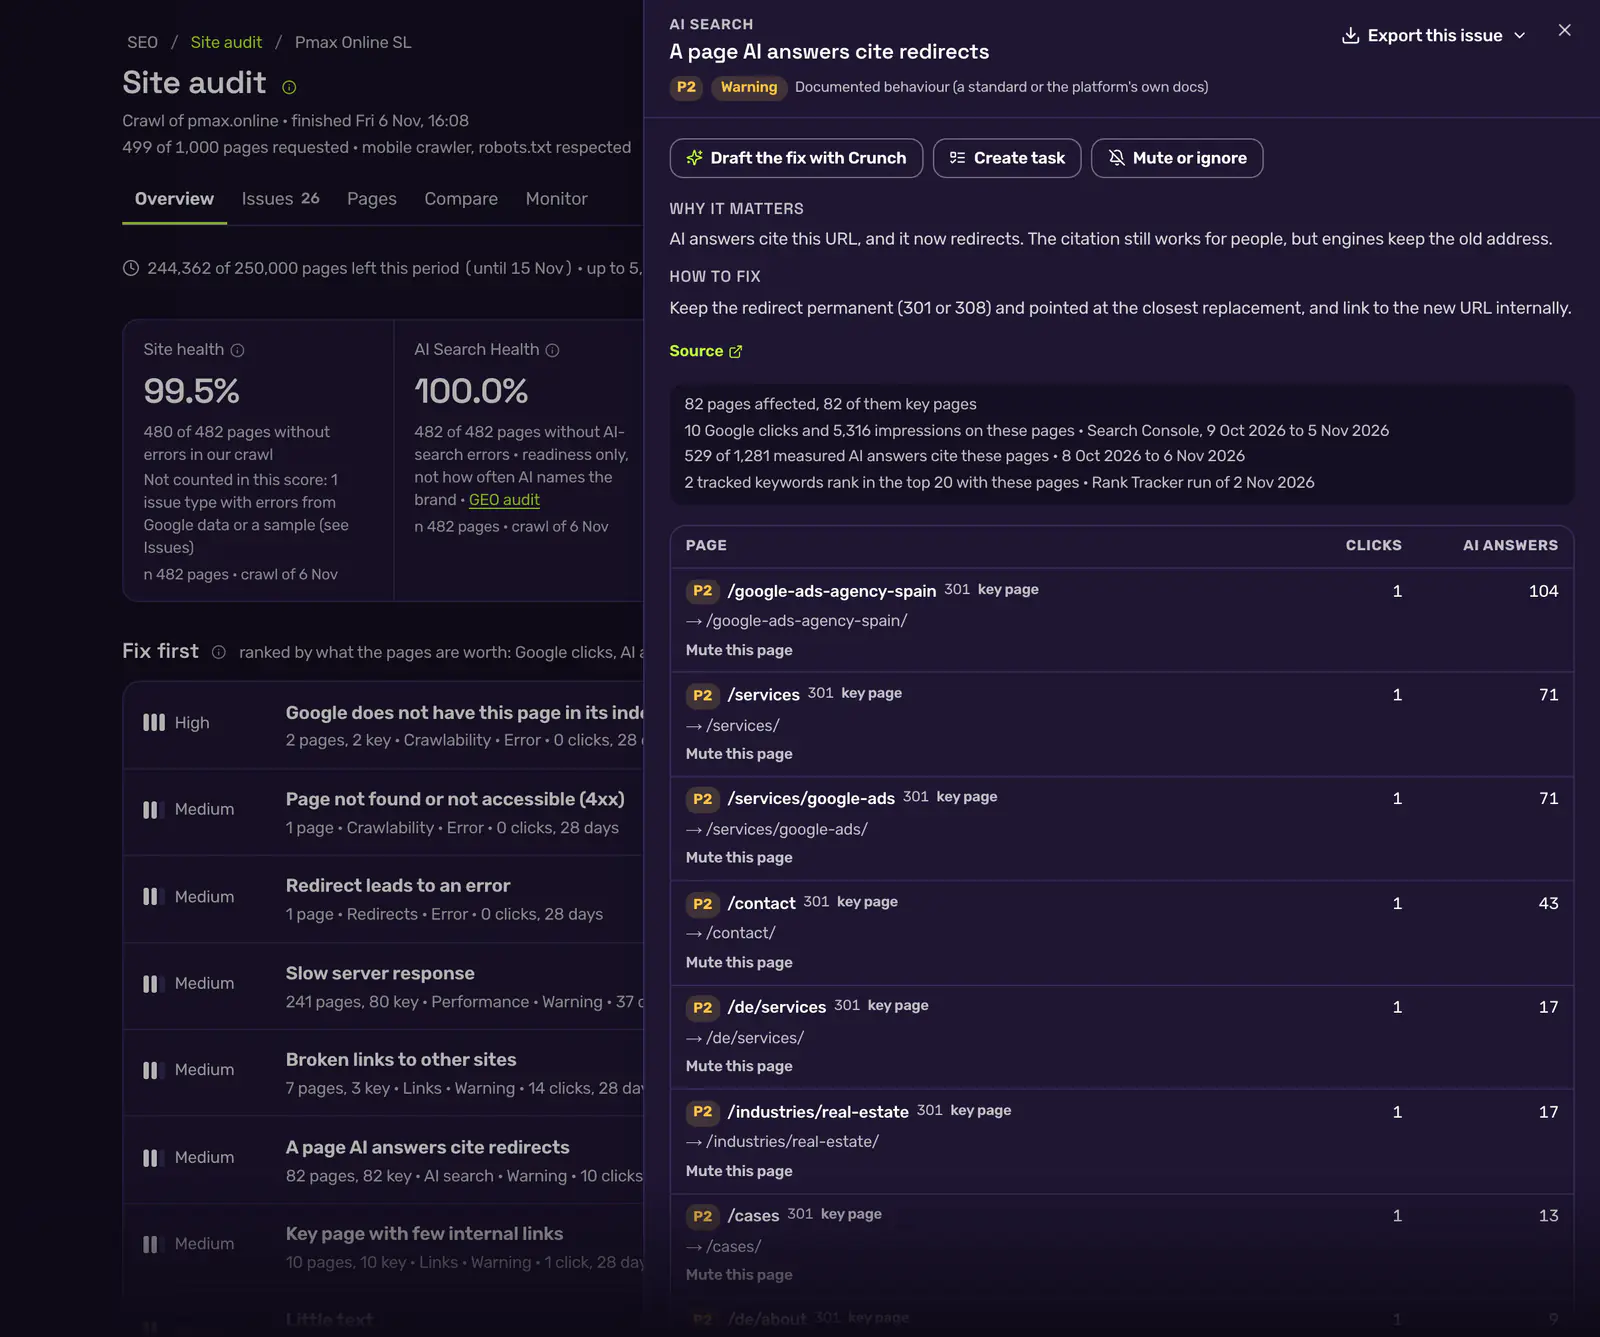
Una página que las respuestas de IA citaron en los últimos 30 días y que ahora devuelve un error, redirige, tiene noindex o está cerrada por el robots.txt aparece la primera. Requiere el seguimiento de visibilidad en IA del cliente.
Lo que lee un rastreador en el HTML
Páginas con casi nada de texto en el HTML, una aplicación vacía, directivas nosnippet, instrucciones ocultas dirigidas a sistemas de IA, datos estructurados ausentes en las páginas clave, un llms.txt ausente o roto, y si las páginas ofrecen una versión en Markdown.
Ordenado por lo que valen las páginas
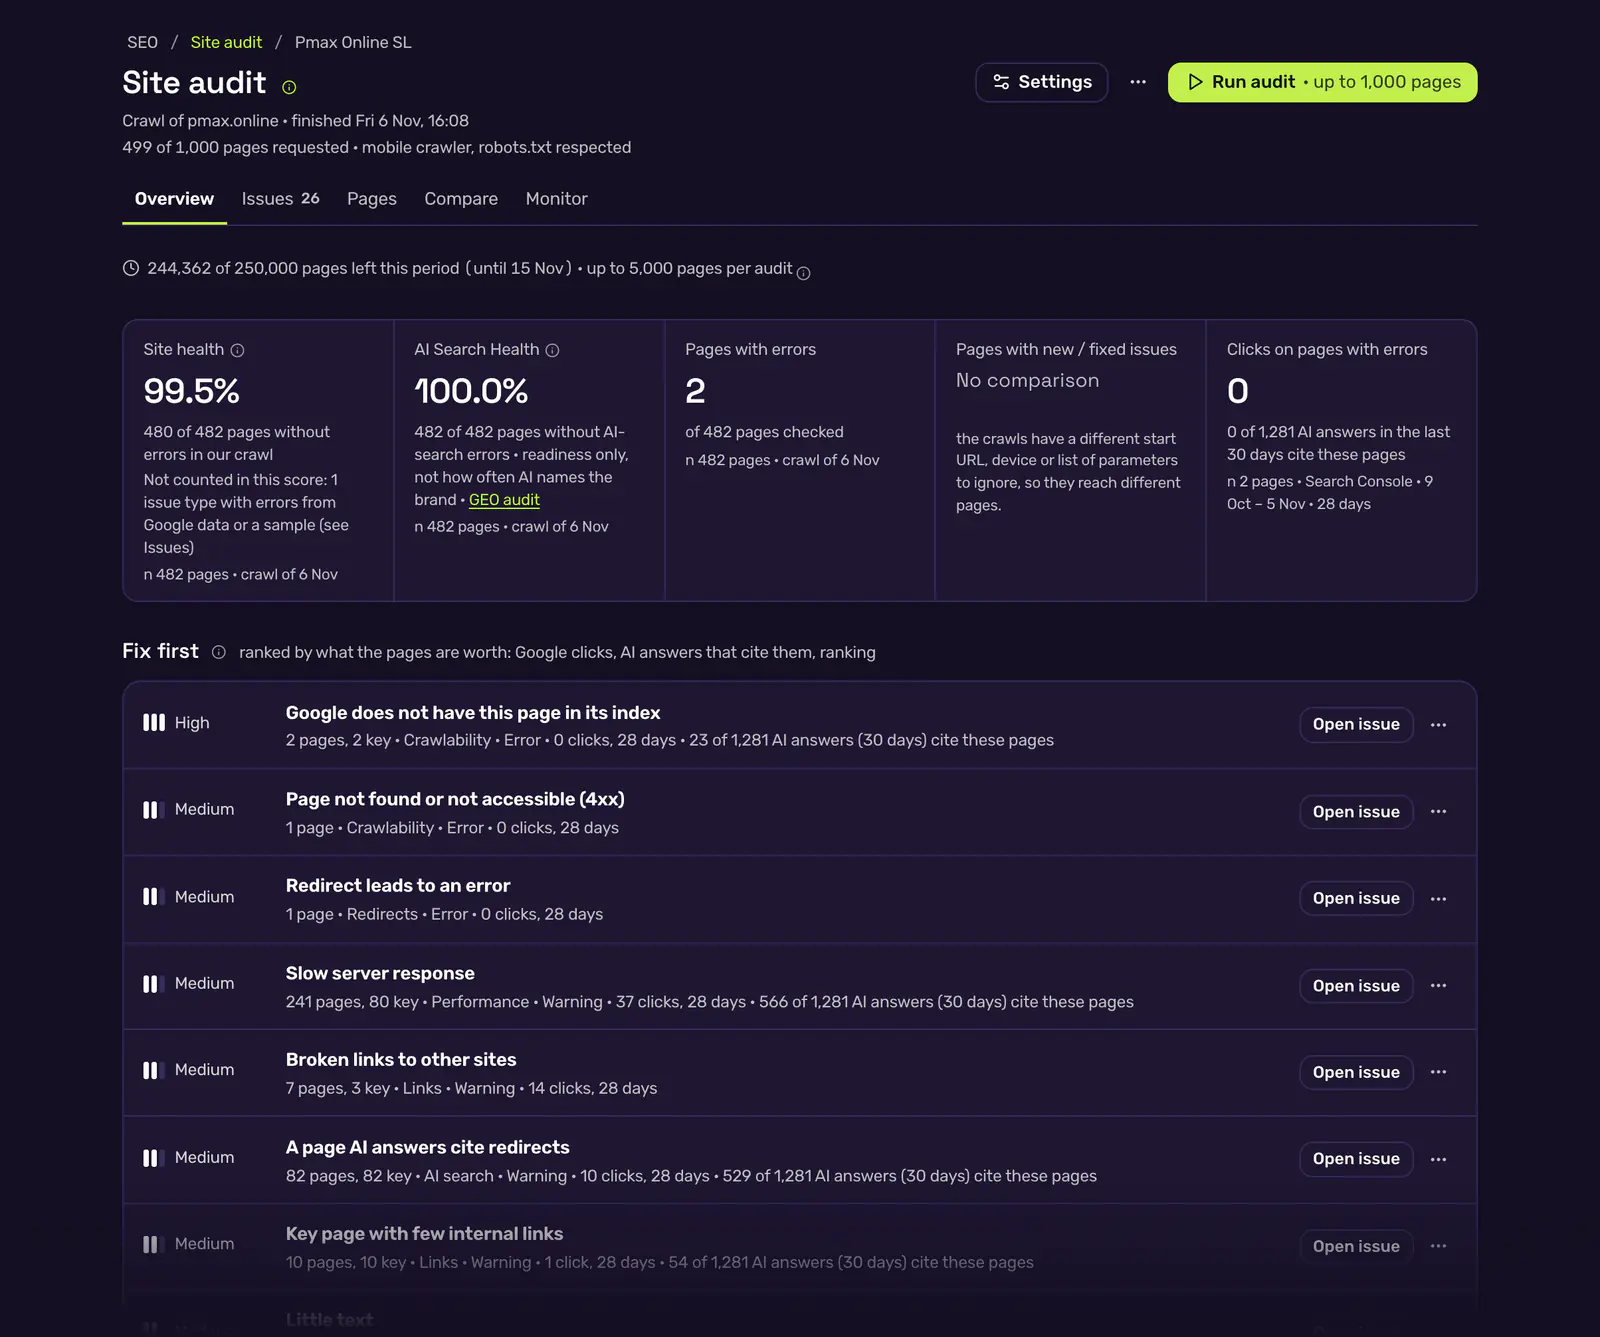
Cada página recibe un nivel de valor según sus clics de Google (Search Console, 28 días), las respuestas de IA que la citan (30 días) y las posiciones de sus palabras clave seguidas. Los problemas se ordenan por prioridad, luego por clics y luego por páginas. Las cifras describen las páginas afectadas; nunca prometen lo que recuperaría una solución.
Dos puntuaciones, nunca promediadas
Site Health y AI Search Health son, cada una, las páginas sin errores entre las páginas evaluadas, con ambas cifras y la fecha del rastreo. Una página que no pudimos medir queda sin evaluar, y los avisos nunca mueven una puntuación.
Cada comprobación muestra en qué se apoya
Cada una de las 189 comprobaciones indica si se apoya en un estándar, en la documentación de una plataforma, en una convención emergente o en una heurística, y enlaza su fuente. Una configuración correcta nunca es un hallazgo, y una comprobación que no pudo ejecutarse lo dice en lugar de darse por superada.
La auditoría SEO clásica también está
Códigos de estado y cadenas de redirecciones, etiquetas canónicas, títulos y meta descripciones, encabezados, enlaces internos, sitemaps, datos estructurados, HTTPS y certificados, contenido duplicado y peso de las páginas.
- Páginas huérfanas halladas a partir de sitemaps, Search Console, GA4 y logs de rastreadores de IA, no solo del rastreo.
- El veredicto de Google sobre las páginas más valiosas (inspección de URL), cuando Search Console está conectado.
- Hreflang solo se evalúa en sitios con más de un idioma: un sitio de un solo idioma nunca recibe un aviso por no tenerlo.
Las páginas que citan las respuestas de IA, y lo que las rompe
Cada problema lista las páginas afectadas con sus clics de Google y las respuestas de IA medidas que las citan, explica por qué importa y cómo arreglarlo, y enlaza la fuente de la regla. Pide a Crunch un borrador del arreglo, conviértelo en tarea o siléncialo.
- Páginas ordenadas por las respuestas de IA y los clics que sostienen
- Cada regla con su fuente: un estándar o la documentación de la propia plataforma
Del hallazgo a la solución
La auditoría vive en el espacio de trabajo que la agencia ya usa, así que un hallazgo no acaba en un PDF.
Rastreo contra rastreo
Problemas nuevos, resueltos y aún abiertos entre dos rastreos, solo cuando ambos tenían el mismo alcance. Resuelto significa comprobado de nuevo y superado.
Señales, no otro panel más
Después de un rastreo, la auditoría puede lanzar Señales con las dos fechas y las páginas evaluadas: errores nuevos en páginas clave, una caída de Site Health, un rastreador de IA bloqueado, una página citada que se rompió. Las automatizaciones pueden actuar sobre ellas.
Tareas y soluciones redactadas
Convierte un problema en una tarea en Aprobaciones, con responsable y fecha límite. Redactar la solución con Crunch escribe la etiqueta, el bloque JSON-LD, las líneas de robots.txt o la regla de redirección de un problema en una página, a partir de lo que guardó el rastreo, solo cuando haces clic.
En el informe del cliente
Site Health, AI Search Health, los problemas principales y el acceso de los rastreadores de IA son una fuente de informe en el editor, en un enlace compartido y en el PDF, con la marca de la agencia.
Desde tu asistente
12 herramientas MCP leen la auditoría, comparan rastreos, cambian ajustes, silencian problemas y crean tareas. Iniciar un rastreo requiere el mismo permiso que las acciones que consumen IA.
En cuatro idiomas
La explicación y el consejo de solución de cada problema están escritos de forma nativa en inglés, alemán, español y francés.
Educado por diseño
El rastreador se identifica como CrunchJunkieSiteAudit, lee el robots.txt antes de cualquier página y lo obedece, sin excepciones. Envía como mucho una solicitud por segundo, respeta un Crawl-delay de hasta 10 segundos y se detiene cuando el sitio rechaza más del 20 % de las solicitudes recientes o responde al robots.txt con un error del servidor.
Cómo permitir o bloquear nuestro rastreador- Solo rastrea el sitio web que pertenece al cliente, después de que alguien confirme que puede auditarlo. Nunca el de un competidor.
- Guarda lo que necesita una auditoría (códigos de estado, títulos, enlaces), no el texto de las páginas. Los rastreos salen de Fráncfort, desde nuestra infraestructura en la UE.
- Una página que el cortafuegos rechaza se informa como rechazada, nunca como rota.
Las páginas están incluidas en tu plan
Cada espacio de trabajo tiene un cupo de páginas por periodo de facturación, compartido por todos sus clientes. Una página cuenta cuando el rastreador la solicita; las páginas que cierra el robots.txt, las imágenes, los scripts y las pruebas no cuentan. No se cobra nada por página y no hay recargo por exceso: un rastreo que no cabe en el cupo restante no se inicia.
| Plan | Páginas al mes | Páginas por rastreo |
|---|---|---|
| Solo | 5000 | 1000 |
| Starter | 25.000 | 5000 |
| Pro | 100.000 | 5000 |
| Agency | 250.000 | 5000 |
| Scale | 1.000.000 | 5000 |
| Prueba | 1000 | 500 |
Páginas por rastreo es lo máximo que puede solicitar un rastreo. Scale se presupuesta de forma individual; su fila es el cupo por defecto.
Lo que no hace
Un rastreo solicita como máximo 5000 páginas, y un cliente se puede auditar 5 veces al día (UTC). Lee el HTML que envía tu servidor y no ejecuta JavaScript, así que el texto que solo aparece después de ejecutar scripts cuenta como ausente. Audita únicamente el sitio web propio del cliente, nunca el de un competidor. No estima lo que recuperaría una solución en posiciones o tráfico. No incluye comprobaciones de accesibilidad ni validación AMP.
Preguntas antes del primer rastreo
Úsala junto a las cifras de visibilidad en IA del mismo cliente: Visibilidad en IA
Mira lo que ve la búsqueda con IA en los sitios de tus clientes
Haz la primera auditoría durante la prueba. Las páginas están incluidas; la primera vez te pide confirmar que puedes auditar el sitio.
Incluida en todos los planes · nada cobrado por página · lee el HTML que envía tu servidor