Alle Beiträge
KI-Sichtbarkeit·21. September 2026·12 Min. Lesezeit

Welche KI-Crawler besuchen deine Website, und was lesen sie?

KI-Crawler tauchen in Google Analytics nicht auf. Die meisten holen dein HTML und gehen wieder, ohne das Tracking-Skript auszuführen. Sichtbar sind sie deshalb nur im Log deines Servers oder CDNs. So liest du dieses Log: welche KI-Crawler kamen, welche Seiten jeder abgerufen hat und ob die, die sich als OpenAI oder Perplexity ausgeben, es wirklich waren. Jeder Befehl unten lief, bevor er hier stand. Die Zahlen stammen aus den Logs von pmax.online, der Website unserer eigenen Agentur: 10.183 Abrufe durch KI-Crawler in 30 Tagen, und von denen, die wir prüfen konnten, war jeder vierte gefälscht.
Von Philipp Enders·Gründer, CrunchJunkie·LinkedInEntwickelt die Reporting- und KI-Sichtbarkeits-Tools, mit denen diese Analyse erstellt wurde.
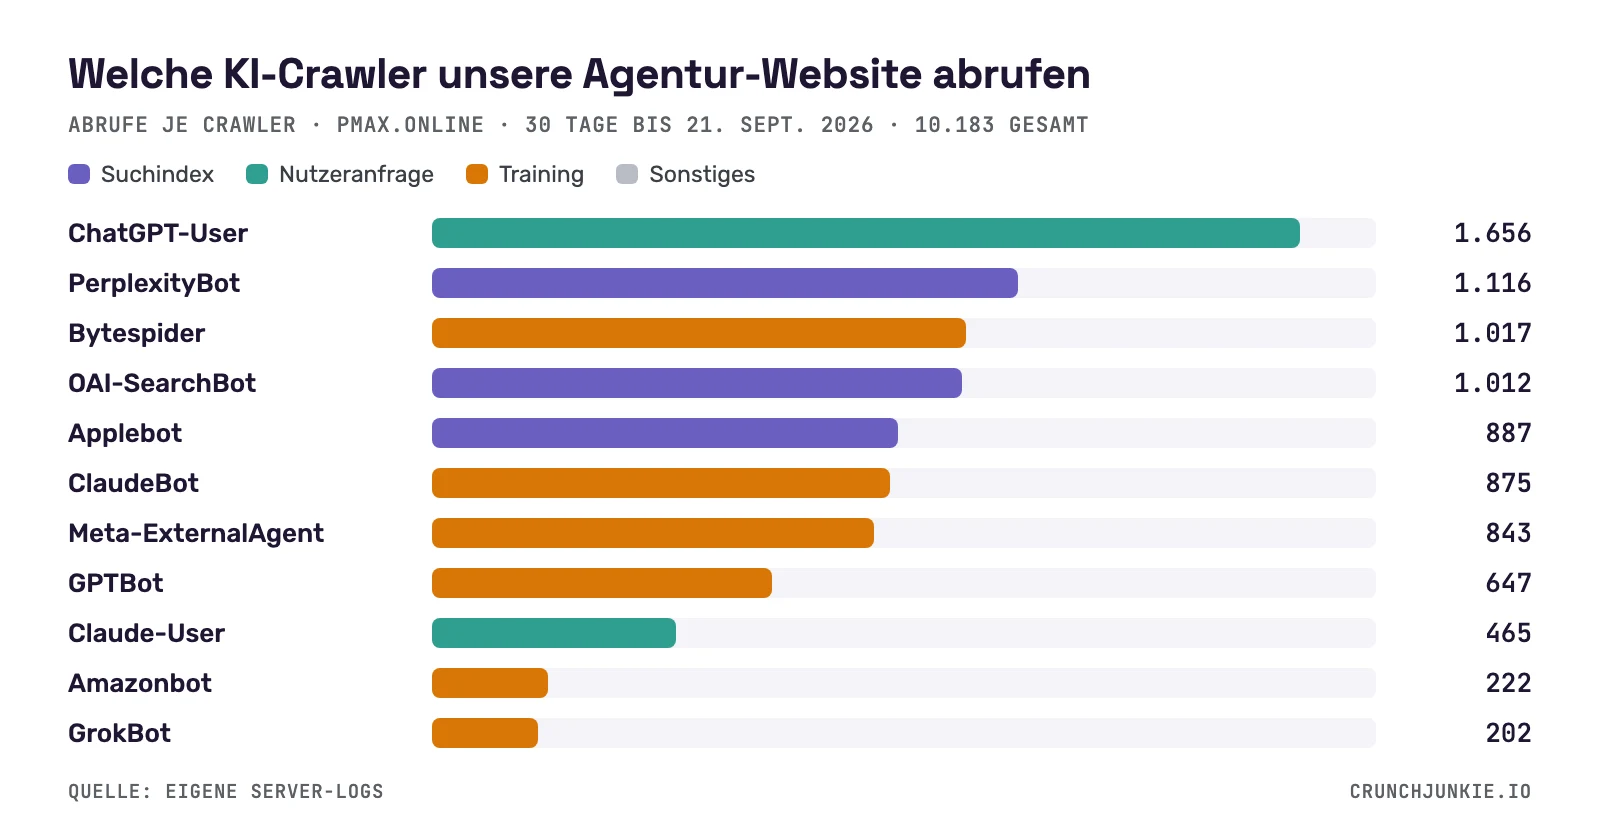
Balkendiagramm der KI-Crawler, die in den 30 Tagen bis 21. September 2026 Seiten von pmax.online abgerufen haben: ChatGPT-User 1.656 Abrufe, PerplexityBot 1.116, Bytespider 1.017, OAI-SearchBot 1.012, Applebot 887, ClaudeBot 875, Meta-ExternalAgent 843, GPTBot 647, Claude-User 465, Amazonbot 222, GrokBot 202, eingefärbt danach, ob der Crawler einen Suchindex baut, eine Nutzeranfrage bedient oder Trainingsdaten sammelt
Abrufe je KI-User-Agent auf der Website unserer Agentur in 30 Tagen, insgesamt 10.183. Am aktivsten ist ChatGPT-User: ChatGPT holt eine Seite, weil gerade jemand etwas gefragt hat.

Die kurze Antwort

Drei Schritte. Zähle in deinem Access-Log die Abrufe je KI-User-Agent. Liste für jeden Crawler die URLs auf, die er abgerufen hat, und die Statuscodes, die er bekam. Prüfe dann die IP-Adressen der Abrufe gegen die IP-Bereiche, die der Betreiber veröffentlicht, denn ein User-Agent ist ein Textfeld, das jeder ausfüllen kann. Wenn du keine Logdateien hast, weil du Cloudflare, Vercel oder Ähnliches nutzt, kommen dieselben Daten aus dem Dashboard der Plattform oder aus einem Log-Export; dazu weiter unten. Du bekommst ein Protokoll des Zugriffs: wer welche Seite angefragt hat und was dein Server geantwortet hat. Du bekommst nicht, was das Modell damit gemacht hat. Ein Abruf ist kein Zitat, und darauf kommen wir am Ende zurück.

Warum Analytics-Tools sie nicht sehen

Google Analytics, Matomo und die anderen zählen einen Besuch, wenn ein Skript im Browser läuft. Die meisten KI-Crawler fordern das HTML an und hören dort auf, und GA4 schließt bekannte Bots zusätzlich aus. Eine Website kann also Tausende Abrufe durch KI-Crawler im Monat haben und keinen davon in ihren Berichten sehen. pmax.online hatte in den letzten 30 Tagen 10.183. Der Server sieht alles. Jeder Abruf ist eine Zeile im Access-Log mit IP-Adresse, Zeit, URL, Statuscode und User-Agent, und diese Zeile wird geschrieben, egal ob ein Skript lief.

Schritt 1: die KI-Crawler im Access-Log zählen

Der Befehl setzt das Combined-Log-Format voraus, den Standard bei nginx und Apache, in dem der User-Agent das letzte Feld in Anführungszeichen ist. Er wandelt den User-Agent in Kleinbuchstaben um, sucht nach einem bekannten KI-Crawler-Namen und zählt einmal pro Abruf. Die naheliegende Variante, grep -o mit uniq -c dahinter, ist falsch, und wir haben es nur gemerkt, weil wir sie getestet haben. Die meisten KI-User-Agents nennen den Crawler zweimal, einmal als Produkt und einmal in der Info-URL (GPTBot/1.3; +https://openai.com/gptbot), und grep -o zählt deshalb jeden Abruf doppelt. Die awk-Variante nimmt den ersten Treffer pro Zeile. Ein Name in der Liste braucht eine Anmerkung. Google-Extended und Applebot-Extended sind robots.txt-Tokens. Google und Apple senden sie nie als User-Agent; die Tokens sagen den beiden nur, was sie mit Seiten tun dürfen, die ihre normalen Crawler geholt haben. Taucht Google-Extended in deinem Log auf, gibt sich also jemand dafür aus. Auf pmax.online kam der Name in 30 Tagen 157-mal vor, und kein einziger dieser Abrufe kam aus Googles Adressbereichen.
awk -F'"' -v re='gptbot|oai-searchbot|chatgpt-user|claudebot|claude-user|claude-searchbot|perplexitybot|perplexity-user|google-extended|googleother|amazonbot|applebot|meta-externalagent|meta-webindexer|bytespider|ccbot|grokbot|deepseekbot|cohere-ai|youbot|duckassistbot|mistralai-user' \
  '{ua=tolower($6); if (match(ua, re)) print substr(ua, RSTART, RLENGTH)}' access.log \
  | sort | uniq -c | sort -rn
Vor der Veröffentlichung auf macOS gegen ein Log im Combined-Format ausgeführt. Ersetze access.log durch deinen Pfad, zum Beispiel /var/log/nginx/access.log. Rotierte Logs sind meist gzip-komprimiert; entpacke sie vorher.

Schritt 2: sehen, was jeder Crawler gelesen hat

Der erste Befehl unter der Tabelle listet die URLs, die ein Crawler abgerufen hat. Er zeigt, was dieser Crawler auf deiner Website für abrufenswert hält, und das ist oft nicht das, was du erwartest. Bei uns war der zweithäufigste Pfad gar keine unserer Seiten; dazu unten mehr. Der zweite Befehl zeigt die Statuscodes je Crawler, und die Tabelle zeigt, wie das auf pmax.online aussah. 6.133 Abrufe bekamen eine Seite. 1.368 bekamen einen 406 und 176 einen 403: zusammen 1.544, also 15,2 %, wurden von einer Firewall-Regel abgewiesen und nicht von der Website, und 412 davon galten Crawlern, die Seiten für Live-Antworten holen. Aus diesem Export lässt sich nicht ablesen, wie viele der blockierten Abrufe die gefälschten von weiter unten waren, und eine Firewall, die Hochstapler aufhält, macht ihre Arbeit. Wie man beides auseinanderhält, steht in 11,6 % der Abrufe durch KI-Crawler enden an einer Firewall. Die robots.txt kann keinen 403 auslösen. Sie ist eine Datei, die der Crawler liest und an die er sich freiwillig hält.
Statuscodes aller 10.183 Abrufe durch KI-Crawler auf pmax.online, 30 Tage bis 21. September 2026.
StatusBedeutungAbrufe
200Seite ausgeliefert6.133
406Von einer Firewall-Regel abgewiesen1.368
404Nicht gefunden1.032
302Temporäre Weiterleitung807
301Permanente Weiterleitung539
403Von einer Firewall-Regel abgewiesen176
520Fehler am Ursprungsserver, vom CDN gemeldet58
409Konflikt58
206, 304, 522Sonstige12
Statuscodes aller 10.183 Abrufe durch KI-Crawler auf pmax.online, 30 Tage bis 21. September 2026.
# Pages one crawler requested, most-requested first
awk -F'"' 'tolower($6) ~ /oai-searchbot/ {split($2, r, " "); print r[2]}' access.log \
  | sort | uniq -c | sort -rn | head -20

# Status codes per crawler
awk -F'"' -v re='gptbot|oai-searchbot|chatgpt-user|claudebot|claude-user|claude-searchbot|perplexitybot|perplexity-user|google-extended|googleother|amazonbot|applebot|meta-externalagent|meta-webindexer|bytespider|ccbot|grokbot|deepseekbot|cohere-ai|youbot|duckassistbot|mistralai-user' \
  '{ua=tolower($6); if (match(ua, re)) {split($3, s, " "); print substr(ua, RSTART, RLENGTH), s[1]}}' access.log \
  | sort | uniq -c | sort -rn
Beide Befehle liefen vor der Veröffentlichung auf macOS gegen ein Log im Combined-Format. Ersetze oai-searchbot durch einen beliebigen Namen aus Schritt 1.

Keine Logdateien? Cloudflare, Vercel und Shared Hosting

Bei Cloudflare zeigt AI Crawl Control die Abrufe je Crawler und je Pfad im Dashboard, und Logpush exportiert rohe Request-Logs, wenn du die Befehle oben ausführen willst. Cloudflare sieht den Abruf vor deinem Server, und das ist wichtig: Ein Abruf, den Cloudflare blockiert, erreicht dein eigenes Log nie. Bei Vercel gibt es keine Access-Log-Datei. Log Drains leiten jeden Request an einen Endpunkt deiner Wahl weiter. Die Einträge sind JSON, die awk-Befehle passen also nicht unverändert, aber die Felder sind dieselben: Pfad, Status, User-Agent, Client-IP. Beim Shared Hosting such im Control Panel nach den rohen Access-Logs. In cPanel heißt der Punkt Raw Access (Rohzugriff) und liefert dieselbe Datei im Combined-Format, die die Befehle erwarten.

Schritt 3: prüfen, ob der Crawler der ist, der er zu sein behauptet

Ein User-Agent ist ein Header. Jeder kann GPTBot senden, und das passiert auch. Geprüft wird über die IP-Adresse. OpenAI, Perplexity und Google veröffentlichen die IP-Bereiche ihrer Crawler als JSON, und ein Abruf von außerhalb stammt nicht von ihnen. Die Tabelle listet die Dateien, die wir bestätigt haben. Das Skript darunter liest eine davon und sagt dir für jede übergebene Adresse, ob sie im Bereich liegt. Google dokumentiert außerdem eine Prüfung per Reverse DNS. Auf pmax.online liefen 4.661 der Abrufe aus 30 Tagen unter den Namen von Betreibern, deren Bereiche wir prüfen konnten. 3.429 waren echt und 1.232 nicht. Das sind 26,4 %, also jeder vierte. 654 gaben sich als OpenAI aus, das sind 20 % von allem, was einen OpenAI-User-Agent trug. 416 gaben sich als Perplexity aus, 35 % von dessen Summe. Alle 162 Abrufe unter einem KI-User-Agent von Google waren gefälscht, 157 davon unter Google-Extended, das Google nie sendet. Was wollten sie? Unser Tool zählt 640 Abrufe, die mit einem Fehler endeten, als Sondierungen, entweder wegen des angefragten Pfads oder weil die Adresse die Prüfung nicht bestand. Wie das aussieht, zeigt das Log: Abrufe von /admin/.env und /api/proc/self/environ unter den Namen ClaudeBot, Applebot, GrokBot und anderen. Da setzt jemand darauf, dass deine Firewall KI-Crawler durchwinkt. Die Quote ist nicht überall gleich: Auf crunchjunkie.io, einer jüngeren Website, fand dieselbe Prüfung 56 Fälschungen unter 2.847 Abrufen, also 2,0 %. Deine eigene Zahl kennst du nur, wenn du die Prüfung laufen lässt. Die übrigen 5.522 Abrufe konnten wir weder bestätigen noch widerlegen. Für Anthropic, ByteDance, Apple, Meta, Amazon und die kleineren Betreiber haben wir keine maschinenlesbare Datei gefunden, die wir bestätigen konnten. Ihre Abrufe markieren wir deshalb als nicht prüfbar und raten nicht. Wenn du eine kennst, sag uns Bescheid.
IP-Bereiche, die die Betreiber selbst als JSON veröffentlichen; alle am 21. September 2026 abgerufen und geprüft.
BetreiberCrawlerVeröffentlichte IP-Bereiche
OpenAIGPTBot
OpenAIOAI-SearchBot
OpenAIChatGPT-User
PerplexityPerplexityBot
PerplexityPerplexity-User
GoogleGooglebot, GoogleOther
GoogleNutzerausgelöste Abrufe
IP-Bereiche, die die Betreiber selbst als JSON veröffentlichen; alle am 21. September 2026 abgerufen und geprüft.
# verify_ai_bot.py — is this IP inside the operator's published range?
import sys, json, ipaddress, urllib.request
feed, ips = sys.argv[1], sys.argv[2:]
data = json.load(urllib.request.urlopen(feed))
nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
for ip in ips:
    ok = any(ipaddress.ip_address(ip) in n for n in nets)
    print(ip, "in the published range" if ok else "NOT in the published range")

# usage: every IP that claimed to be GPTBot, checked against OpenAI's file
# python3 verify_ai_bot.py https://openai.com/gptbot.json \
#   $(awk -F'"' 'tolower($6) ~ /gptbot/ {split($1, a, " "); print a[1]}' access.log | sort -u)
Am 21. September 2026 gegen openai.com/gptbot.json und openai.com/searchbot.json ausgeführt: Eine Adresse aus OpenAIs Bereich wurde als innerhalb gemeldet, eine erfundene als außerhalb.

Die User-Agents, die man kennen sollte, und wofür jeder da ist

In dieser Liste stehen drei Arten von Crawlern, und sie bedeuten Verschiedenes. Trainings-Crawler sammeln Text für ein künftiges Modell. Such-Crawler bauen den Index, in dem ein Assistent sucht, wenn er antwortet. Nutzerausgelöste Abrufe holen eine einzelne Seite, weil gerade jemand etwas gefragt hat, wofür sie gebraucht wird. Die erste Art zu blockieren ist eine Grundsatzentscheidung. Die beiden anderen zu blockieren nimmt dich heute aus den Antworten. An OpenAI sieht man, warum der Unterschied zählt. Von dort kamen in 30 Tagen 3.315 Abrufe, und die Hälfte davon, 1.656, war ChatGPT-User: Jemand hat ChatGPT etwas gefragt, und es hat eine unserer Seiten geholt, um zu antworten. OAI-SearchBot kam auf 1.012, der Trainings-Crawler GPTBot auf 647. Eine robots.txt-Regel gegen GPTBot ist die Regel, mit der die meisten Anleitungen beginnen. Hier betrifft sie 20 % von OpenAIs Abrufen und nichts von dem Teil, der Menschen antwortet. Auf crunchjunkie.io sind es 2 %.
Die 21 KI-User-Agents in den Logs von pmax.online, 30 Tage bis 21. September 2026, 10.183 Abrufe. Art = wofür der Betreiber den Crawler laut eigener Dokumentation einsetzt; Sonstiges = keiner der drei Typen. Die Zahlen zählen jeden Abruf unter diesem Namen, auch die gefälschten.
CrawlerBetreiberArtWofürAbrufe
ChatGPT-UserOpenAINutzeranfrageRuft eine Seite ab, wenn die Anfrage eines ChatGPT-Nutzers sie braucht1.656
PerplexityBotPerplexitySuchindexBaut den Index für Perplexitys Antworten1.116
BytespiderByteDanceTrainingCrawler von ByteDance; nicht dokumentiert, gilt allgemein als Trainings-Crawler1.017
OAI-SearchBotOpenAISuchindexBaut den Index für die ChatGPT-Suche1.012
ApplebotAppleSuchindexApples Such-Crawler hinter Siri und Spotlight887
ClaudeBotAnthropicTrainingSammelt Trainingsdaten für Anthropics Modelle875
Meta-ExternalAgentMetaTrainingSammelt Daten für Metas KI-Modelle843
GPTBotOpenAITrainingSammelt Trainingsdaten für OpenAIs Modelle647
Claude-UserAnthropicNutzeranfrageRuft eine Seite ab, wenn die Anfrage eines Claude-Nutzers sie braucht465
AmazonbotAmazonTrainingAmazons Crawler; laut Amazon auch für das Training von KI-Modellen222
GrokBotxAITrainingCrawler von xAI für Grok202
YouBotYou.comSonstigesCrawler von You.com für dessen KI-Suche170
Claude-SearchBotAnthropicSuchindexBaut den Suchindex, den Claude nutzt169
Google-Extended(claims Google)TrainingEin robots.txt-Token, kein Crawler. Google sendet es nie; alle 157 Abrufe hier waren gefälscht157
MistralAI-UserMistralNutzeranfrageRuft eine Seite ab, wenn die Anfrage eines Le-Chat-Nutzers sie braucht147
DeepSeekBotDeepSeekTrainingCrawler von DeepSeek141
cohere-aiCohereTrainingCrawler von Cohere139
DuckAssistBotDuckDuckGoNutzeranfrageRuft Seiten bei Bedarf für DuckDuckGos DuckAssist-Antworten ab131
CCBotCommon CrawlTrainingCrawler von Common Crawl; dessen offener Datensatz wird häufig für Training genutzt114
Perplexity-UserPerplexityNutzeranfrageRuft eine Seite ab, wenn die Anfrage eines Perplexity-Nutzers sie braucht68
Google user-triggered agent(claims Google)NutzeranfrageGab sich als nutzerausgelöster Google-Abruf aus; alle 5 Abrufe kamen von außerhalb der Google-Bereiche5
Die 21 KI-User-Agents in den Logs von pmax.online, 30 Tage bis 21. September 2026, 10.183 Abrufe. Art = wofür der Betreiber den Crawler laut eigener Dokumentation einsetzt; Sonstiges = keiner der drei Typen. Die Zahlen zählen jeden Abruf unter diesem Namen, auch die gefälschten.

Was wir in unseren eigenen Logs gefunden haben

In den 30 Tagen bis zum 21. September 2026 gab es auf pmax.online 10.183 Abrufe unter 21 KI-User-Agents von 15 Betreibern. Auf OpenAI entfallen 33 %, auf Anthropic 15 % und auf Perplexity 12 %. 4.357 Abrufe kamen von Trainings-Crawlern, 3.184 von Such-Crawlern, und 2.472 waren nutzerausgelöst; die übrigen 170 sind YouBot, der in keine der drei Arten passt. Zwei Pfade haben uns mehr beigebracht als die Summen. Der zweithäufigste Pfad auf pmax.online, nach der Startseite, ist /cgi-sys/suspendedpage.cgi mit 698 Abrufen. Das ist die Seite, die ein Hoster zeigt, wenn ein Account gesperrt ist. Unserer war es, für einen Teil dieses Zeitraums, und solange das dauerte, bekam jeder KI-Crawler, der vorbeikam, diese Seite. Analytics hätte einen Einbruch bei den Besuchern gezeigt. Was den Crawlern ausgeliefert wurde, zeigt nur das Log. Die 807 temporären Weiterleitungen in der Statustabelle sind sehr wahrscheinlich die andere Hälfte derselben Episode, denn ein gesperrter Account leitet jede Seite auf diese Adresse um. Der andere stammt von crunchjunkie.io. Dort steht Claude-User in denselben 30 Tagen mit 813 Abrufen in der Liste, und danach wären Claude-Nutzer die aktivsten KI-Leser dieser Website. Sind sie nicht. 804 Abrufe gingen an /api/mcp/mcp, den Endpunkt unseres MCP-Connectors, den Claude aufruft, wenn jemand CrunchJunkie aus Claude heraus nutzt, und alle 27 davon, die fehlgeschlagen sind, trugen den User-Agent Claude-User. Beide Fälle sagen dasselbe: Lies erst die Pfade, bevor du die Summe eines Crawlers als Interesse an deinen Inhalten liest. Die vollständige Tabelle gibt es als CSV-Datei, veröffentlicht unter CC BY 4.0.
10.183 Abrufe nach Art des Crawlers, pmax.online, 30 Tage bis 21. September 2026, nach dem Namen, den der Abruf trug.
ArtAbrufeAnteilCrawler
Training4.35742,8 %Bytespider, ClaudeBot, Meta-ExternalAgent, GPTBot, Amazonbot, GrokBot, Google-Extended, DeepSeekBot, cohere-ai, CCBot
Suchindex3.18431,3 %PerplexityBot, OAI-SearchBot, Applebot, Claude-SearchBot
Nutzeranfrage2.47224,3 %ChatGPT-User, Claude-User, MistralAI-User, DuckAssistBot, Perplexity-User, Google user-triggered agent
Sonstiges1701,7 %YouBot
10.183 Abrufe nach Art des Crawlers, pmax.online, 30 Tage bis 21. September 2026, nach dem Namen, den der Abruf trug.

Was die Logs nicht sagen können

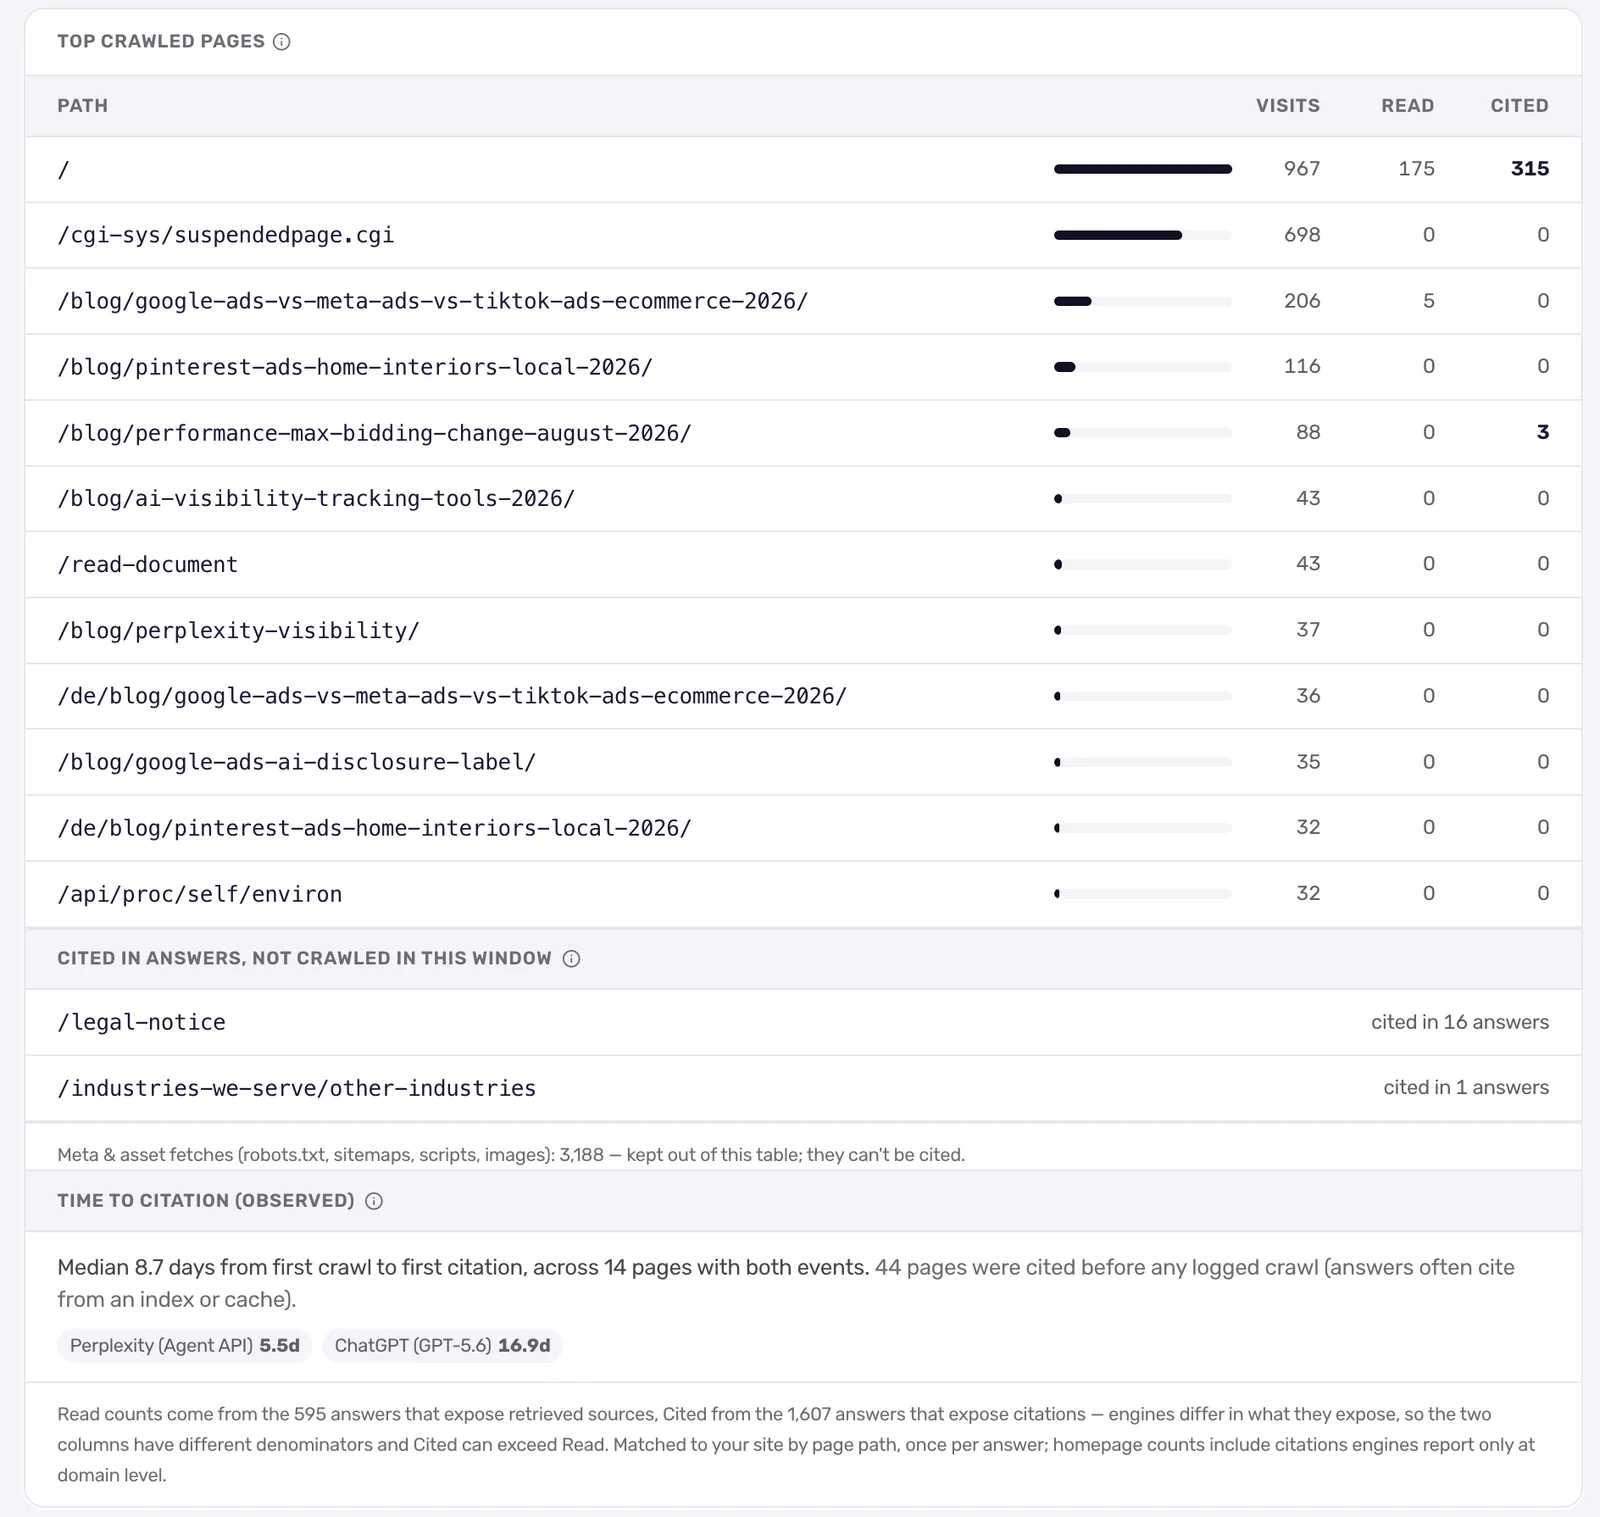
Eine Logzeile belegt einen Abruf. Sie belegt nicht, dass die Seite verwendet wurde. Assistenten antworten meist aus einem Index oder Cache, der früher gebaut wurde. Eine Seite kann also ohne frischen Abruf zitiert werden und abgerufen werden, ohne je zitiert zu werden. Beide Richtungen können wir an pmax.online zeigen, weil wir auch verfolgen, was die Engines antworten. In den 2.141 Antworten, die wir im selben Zeitraum verfolgt haben, wurde die Startseite 967-mal von KI-Crawlern abgerufen, in 175 Antworten herangezogen und in 315 zitiert. Der meistgecrawlte Blogartikel, ein Vergleich von Google, Meta und TikTok Ads, wurde 206-mal abgerufen, in 5 Antworten herangezogen und in keiner zitiert. In der anderen Richtung: Das Impressum wurde in 16 Antworten zitiert, und kein KI-Crawler hat es in diesen 30 Tagen auch nur einmal abgerufen. Über den Zeitraum hinaus: Für die 14 Seiten, bei denen wir sowohl einen ersten Abruf als auch ein späteres erstes Zitat protokolliert haben, liegt der Median dazwischen bei 8,7 Tagen, und 44 Seiten wurden zitiert, bevor wir je einen Abruf von ihnen protokolliert hatten. Gecrawlt zu werden ist irgendwann nötig, und es entscheidet nichts. Die Logs beantworten also die halbe Frage aus dem Titel. Sie sagen, was die Crawler abgerufen haben. Um zu sehen, was die Engines danach sagen, musst du sie fragen, wiederholt, und die Quellen lesen, die sie angeben: so prüfst du, ob KI-Chatbots deine Website zitieren. Und zitiert zu werden ist noch nicht dasselbe wie empfohlen zu werden; darum geht es in zitiert ist nicht genannt. Wie man das Log als Ganzes liest, über die Befehle hinaus, steht in KI-Crawl-Logs richtig lesen.
Crawl-Insights-Ansicht von CrunchJunkie für pmax.online mit den Seiten, die KI-Crawler in 30 Tagen am häufigsten abgerufen haben, in drei Spalten, Visits, Read und Cited: die Startseite mit 967 Abrufen, in 175 Antworten herangezogen und in 315 zitiert; die Sperrseite des Hosters mit 698 Abrufen, nie herangezogen oder zitiert; ein Blogartikel über Google, Meta und TikTok Ads mit 206 Abrufen, 5-mal herangezogen, 0-mal zitiert; darunter das Impressum, in 16 Antworten zitiert ohne einen Abruf, und ein Median von 8,7 Tagen vom ersten Abruf bis zum ersten Zitat über 14 Seiten
Dieselben 30 Tage im Tool (englische Oberfläche): was KI-Crawler abgerufen haben (Visits), daneben wie oft unsere verfolgten KI-Antworten die Seite herangezogen (Read) und zitiert (Cited) haben. Der meistgecrawlte Blogartikel wurde nie zitiert; das Impressum wurde 16-mal zitiert, ohne einen einzigen Abruf.

Dranbleiben

Ein einmaliger Befehl ist eine Momentaufnahme. Was sich über die Zeit zu beobachten lohnt, ist eine kurze Liste: ein Crawler, der verschwindet, ein Sprung bei den 403ern oder 406ern nach einer Änderung an Firewall oder CDN, ein User-Agent, den du noch nie gesehen hast, mehr Abrufe, die die Adressprüfung nicht bestehen. Die drei Befehle einmal im Monat auszuführen reicht für die meisten Websites. Ein Cronjob mit einem Diff ist besser. Wir haben das als Crawl Insights in CrunchJunkie eingebaut, weil wir das Crawl-Log neben den Antworten haben wollten; das ist der Vergleich aus dem Abschnitt oben. Wenn du nur wissen willst, ob die Antwort-Crawler dich gerade erreichen, prüft das der kostenlose GEO-Audit live und ohne Logs.

Häufige Fragen

Such im Access-Log deines Servers oder CDNs nach GPTBot im Feld User-Agent; Analytics-Tools zeigen ihn nicht, weil der Crawler ihr Skript nie ausführt. Prüfe danach, ob die IP-Adresse des Abrufs in dem Bereich liegt, den OpenAI unter openai.com/gptbot.json veröffentlicht, denn diesen User-Agent kann jeder senden. Auf der Website unserer Agentur kamen in 30 Tagen 647 von 3.315 OpenAI-Abrufen von GPTBot. Die Hälfte der OpenAI-Abrufe kam von ChatGPT-User, der eine Seite holt, wenn die Frage eines Menschen sie braucht.

Nein. Analytics-Tools zählen einen Besuch, wenn ihr Skript im Browser läuft, und die meisten KI-Crawler holen das HTML, ohne ein Skript auszuführen. GA4 schließt bekannte Bots außerdem automatisch aus. Sichtbar sind die Abrufe in Server-Access-Logs, in CDN-Logs und Dashboards wie Cloudflares AI Crawl Control und in Log-Exporten wie den Vercel Log Drains.

Alle drei gehören OpenAI. GPTBot sammelt Trainingsdaten für künftige Modelle. OAI-SearchBot baut den Index, aus dem die ChatGPT-Suche schöpft. ChatGPT-User ruft eine einzelne Seite ab, wenn die Anfrage eines Nutzers sie braucht. GPTBot zu blockieren betrifft die beiden anderen nicht. Auf der Website unserer Agentur kam ChatGPT-User in 30 Tagen auf 1.656 Abrufe, OAI-SearchBot auf 1.012 und GPTBot auf 647.

Vergleiche die IP-Adresse des Abrufs mit den IP-Bereichen, die der Betreiber veröffentlicht. OpenAI, Perplexity und Google veröffentlichen sie als JSON-Dateien, und ein Abruf von außerhalb stammt nicht von ihnen, egal was der User-Agent sagt. In 30 Tagen Logs von der Website unserer Agentur kamen 1.232 von 4.661 prüfbaren Abrufen durch KI-Crawler, also 26,4 %, von außerhalb der veröffentlichten Bereiche. Bei Betreibern ohne solche Datei lässt sich ein Abruf weder bestätigen noch widerlegen.

Nein. Ein Logeintrag zeigt, dass eine Seite abgerufen wurde. Ob ein Assistent sie später verwendet oder zitiert, ist eine andere Frage, und Assistenten antworten oft aus einem früher gebauten Index. Auf der Website unserer Agentur wurde der meistgecrawlte Blogartikel in 30 Tagen 206-mal von KI-Crawlern abgerufen, in 5 der 2.141 KI-Antworten herangezogen, die wir im selben Zeitraum verfolgt haben, und in keiner zitiert. Eine Seite, die in dieser Zeit kein Crawler abgerufen hat, wurde in 16 zitiert.

Weiterlesen

Sieh die KI-Sichtbarkeit deiner eigenen Marke

Reporting und KI-Sichtbarkeit in einer Konsole — erstell deinen ersten Bericht und Scan in der 14-tägigen Testphase.

14 Tage testen