 Audit SEO
La recherche IA accède-t-elle
au site de votre client ?
Un crawl du site web propre du client qui commence par la recherche IA : quels robots IA le robots.txt et le pare-feu laissent entrer, quelles pages citées sont cassées, ce qu'un robot lit dans le HTML. Ensuite, les vérifications SEO classiques, chaque problème classé selon ce que valent les pages qu'il touche.
Les pages sont incluses dans le forfait : rien n'est facturé par page et il n'y a pas de dépassement. L'audit lit le HTML envoyé par votre serveur et n'exécute pas JavaScript.
La recherche IA d'abord, le reste ensuite
La plupart des outils d'audit commencent par les titres et les liens cassés. Celui-ci commence par savoir si la recherche IA peut accéder au site et le lire.
Accès des robots IA, testé
Le robots.txt est confronté page par page aux robots de recherche IA et aux récupérateurs IA. Ensuite, l'audit demande une fois la page d'accueil avec le user agent publié de chacun des 8 robots IA, ce qui révèle un pare-feu ou un CDN qui refuse un robot que le robots.txt autorise. Un refus est signalé comme un refus, avec la couche concernée quand elle peut être nommée. Si vous connectez vos journaux de serveur, l'audit montre aussi où des robots IA vérifiés ont été refusés ces 14 derniers jours.
Pages citées par les réponses IA
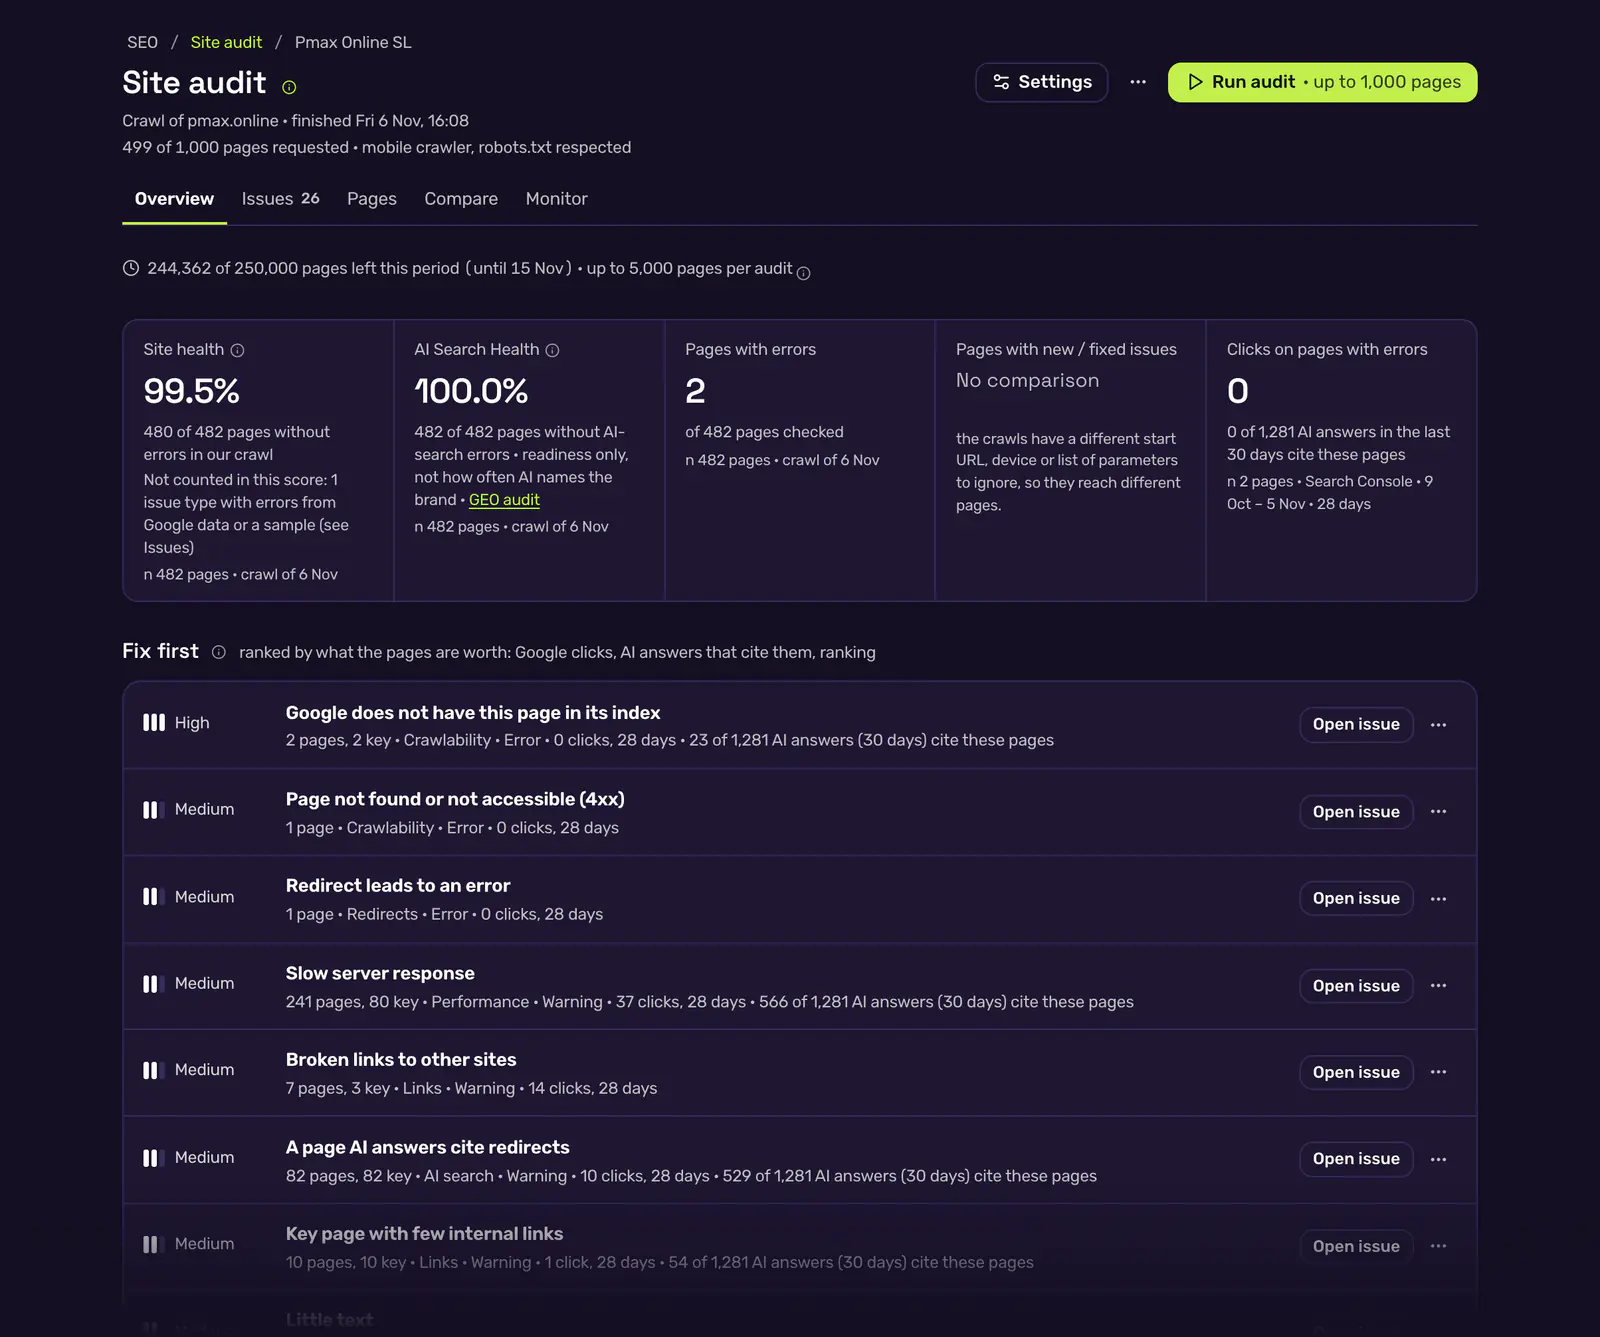
Une page que des réponses IA ont citée ces 30 derniers jours et qui renvoie désormais une erreur, redirige, est en noindex ou est fermée par le robots.txt arrive en tête de liste. Cela suppose le suivi de la visibilité IA du client.
Ce qu'un robot lit dans le HTML
Des pages avec presque aucun texte dans le HTML, une application vide, des directives nosnippet, des instructions cachées adressées aux systèmes d'IA, des données structurées absentes sur les pages clés, un llms.txt absent ou cassé, et la présence ou non d'une version Markdown des pages.
Classé selon la valeur des pages
Chaque page reçoit un niveau de valeur d'après ses clics Google (Search Console, 28 jours), les réponses IA qui la citent (30 jours) et les positions de ses mots-clés suivis. Les problèmes sont triés par priorité, puis par clics, puis par pages. Les chiffres décrivent les pages concernées ; ils ne promettent jamais ce qu'une correction rapporterait.
Deux scores, jamais moyennés
Site Health et AI Search Health sont chacun les pages sans erreur sur les pages évaluées, avec les deux chiffres et la date du crawl. Une page que nous n'avons pas pu mesurer n'est pas évaluée, et les remarques ne font jamais bouger un score.
Chaque vérification montre sa base
Chacune des 189 vérifications indique si elle repose sur une norme, sur la documentation d'une plateforme, sur une convention émergente ou sur une heuristique, et renvoie à sa source. Une configuration correcte n'est jamais un constat, et une vérification qui n'a pas pu s'exécuter le dit au lieu de passer.
L'audit SEO classique est aussi là
Codes d'état et chaînes de redirections, balises canoniques, titres et méta-descriptions, titres de section, liens internes, sitemaps, données structurées, HTTPS et certificats, contenu dupliqué et poids des pages.
- Des pages orphelines trouvées à partir des sitemaps, de Search Console, de GA4 et des journaux de robots IA, pas seulement du crawl.
- Le verdict de Google sur les pages les plus précieuses (inspection d'URL), quand Search Console est connecté.
- Hreflang n'est évalué que sur les sites de plus d'une langue : un site monolingue n'est jamais signalé pour son absence.
Les pages que citent les réponses IA, et ce qui les casse
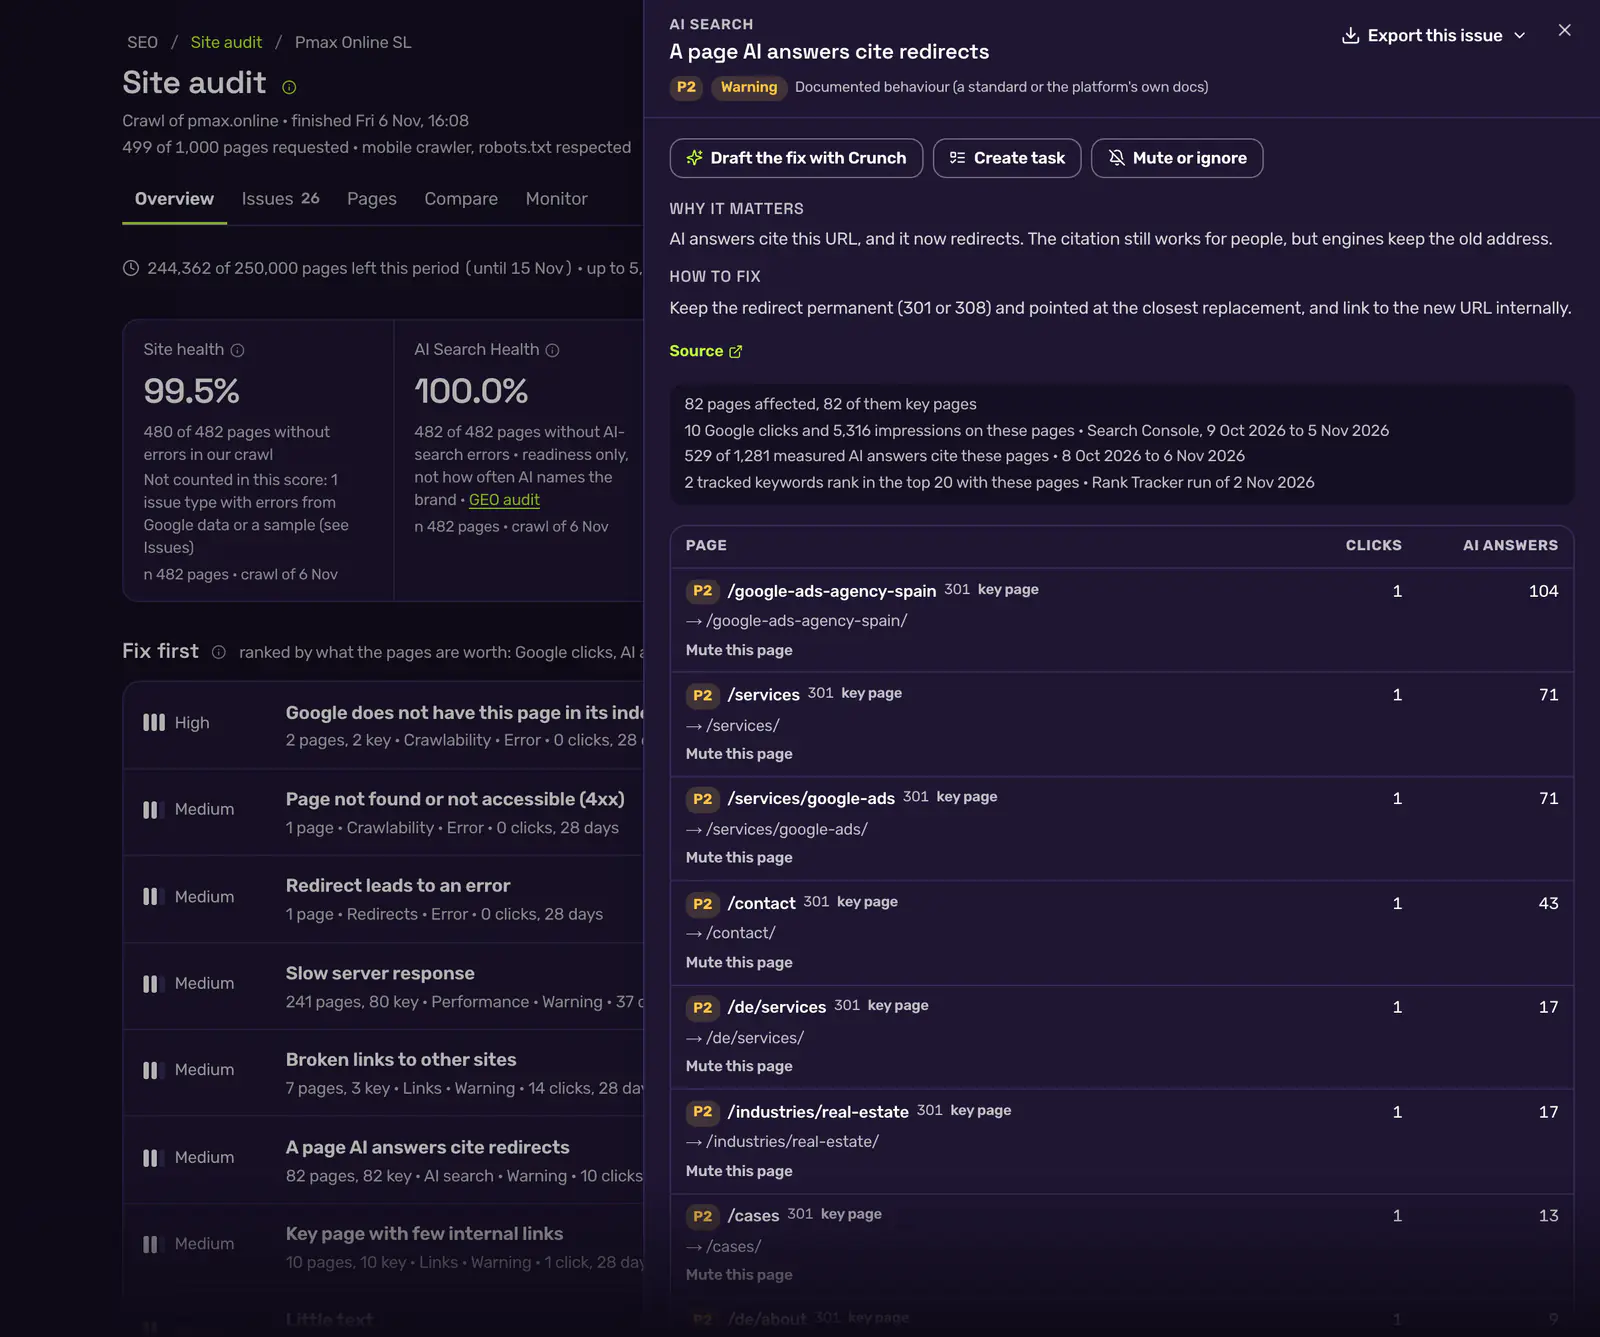
Chaque problème liste les pages touchées avec leurs clics Google et les réponses IA mesurées qui les citent, explique pourquoi il compte et comment le corriger, et renvoie à la source de la règle. Faites rédiger la correction par Crunch, créez une tâche ou masquez-le.
- Pages classées selon les réponses IA et les clics qu'elles portent
- Chaque règle avec sa source : une norme ou la documentation de la plateforme elle-même
Du constat à la correction
L'audit vit dans l'espace de travail que l'agence utilise déjà : un constat ne finit donc pas dans un PDF.
Crawl contre crawl
Problèmes nouveaux, corrigés et encore ouverts entre deux crawls, seulement quand les deux avaient la même portée. Corrigé veut dire revérifié et conforme.
Des signaux, pas un tableau de bord de plus
Après un crawl, l'audit peut lever des signaux avec les deux dates et les pages évaluées : nouvelles erreurs sur des pages clés, une baisse de Site Health, un robot IA bloqué, une page citée qui s'est cassée. Les automatisations peuvent agir dessus.
Tâches et corrections rédigées
Transformez un problème en tâche dans Approbations, avec un responsable et une échéance. Rédiger la correction avec Crunch écrit la balise, le bloc JSON-LD, les lignes de robots.txt ou la règle de redirection pour un problème sur une page, à partir de ce que le crawl a enregistré, uniquement quand vous cliquez.
Dans le rapport client
Site Health, AI Search Health, les principaux problèmes et l'accès des robots IA sont une source de rapport dans l'éditeur, sur un lien de partage et dans le PDF, aux couleurs de l'agence.
Depuis votre assistant
12 outils MCP lisent l'audit, comparent des crawls, modifient les réglages, mettent des problèmes en sourdine et créent des tâches. Lancer un crawl demande la même autorisation que les actions qui consomment de l'IA.
En quatre langues
L'explication et le conseil de correction de chaque problème sont écrits nativement en anglais, en allemand, en espagnol et en français.
Poli par conception
Le robot s'identifie comme CrunchJunkieSiteAudit, lit le robots.txt avant toute page et le respecte, sans exception. Il envoie au plus une requête par seconde, suit un Crawl-delay allant jusqu'à 10 secondes et s'arrête quand le site refuse plus de 20 % des requêtes récentes ou répond au robots.txt par une erreur serveur.
Comment autoriser ou bloquer notre robot- Il n'explore que le site web qui appartient au client, une fois que quelqu'un a confirmé avoir le droit de l'auditer. Jamais celui d'un concurrent.
- Il conserve ce dont un audit a besoin (codes d'état, titres, liens), pas le texte des pages. Les crawls partent de Francfort, depuis notre infrastructure dans l'UE.
- Une page que le pare-feu refuse est signalée comme refusée, jamais comme cassée.
Les pages sont incluses dans votre forfait
Chaque espace de travail dispose d'un quota de pages par période de facturation, partagé par tous ses clients. Une page compte quand le robot la demande ; les pages fermées par le robots.txt, les images, les scripts et les tests ne comptent pas. Rien n'est facturé par page et il n'y a pas de dépassement : un crawl qui ne tient pas dans le quota restant ne démarre pas.
| Forfait | Pages par mois | Pages par crawl |
|---|---|---|
| Solo | 5 000 | 1 000 |
| Starter | 25 000 | 5 000 |
| Pro | 100 000 | 5 000 |
| Agency | 250 000 | 5 000 |
| Scale | 1 000 000 | 5 000 |
| Essai | 1 000 | 500 |
Pages par crawl est le maximum qu'un crawl peut demander. Scale est tarifé au cas par cas ; sa ligne indique le quota par défaut.
Ce qu'il ne fait pas
Un crawl demande au plus 5 000 pages, et un client peut être audité 5 fois par jour (UTC). Il lit le HTML envoyé par votre serveur et n'exécute pas JavaScript : un texte qui n'apparaît qu'après l'exécution de scripts compte donc comme absent. Il audite uniquement le site web propre du client, jamais celui d'un concurrent. Il n'estime pas ce qu'une correction rapporterait en positions ou en trafic. Les vérifications d'accessibilité et la validation AMP ne sont pas incluses.
Questions avant le premier crawl
Utilisez-le à côté des chiffres de visibilité IA du même client : Visibilité IA
Voyez ce que la recherche IA voit sur les sites de vos clients
Lancez le premier audit pendant l'essai. Les pages sont incluses ; la première fois, on vous demande de confirmer que vous avez le droit d'auditer le site.
Inclus dans tous les forfaits · rien de facturé par page · lit le HTML envoyé par votre serveur